GEO 논문의 「+40%」는 AI가 글을 인용할 확률이 40% 오른다는 숫자가 아닙니다. 구글 검색 상위 5개 페이지가 답변 안에서 나눠 가진 분량의 몫이 최대 40%쯤 커졌다는 숫자이고, 이것을 「흡수」라고 부를 수 있습니다. 이 글은 논문 원문의 문장과 표를 따라가며 그 숫자의 정체를 확인합니다. (2026년 10월 기준)
GEO 「+40%」는 무엇을 잰 숫자인가: 한 줄 답
2편에서 본 Aggarwal 등의 논문(arXiv 2311.09735) 초록에는 GEO가 생성형 엔진 응답 안에서 가시성을 최대 40% 높일 수 있다는 문장이 있습니다. 이 40%가 잰 것은 「답 안에서 차지하는 분량의 몫」입니다. 「인용되느냐 아니냐」를 잰 숫자가 아닙니다. 논문은 이 분량 몫을 위치까지 반영한 단어 수라는 지표와, 주관적 인상을 매긴 점수로 쟀습니다.
인용과 흡수는 무엇이 다른가
두 낱말을 먼저 나눠 두면 이후가 쉬워집니다. 이 글에서는 아래처럼 씁니다.
| 구별 | 무엇을 묻는가 | 값의 모양 |
|---|---|---|
| 인용(selection) | 답변에 이 페이지가 출처로 붙었는가 | 예·아니오 (0 또는 1) |
| 흡수(absorption) | 출처로 붙은 페이지들 가운데 이 페이지가 답의 얼마만큼을 가져갔는가 | 분량의 몫 |
인용은 문 안에 들어왔는지를 보는 것이고, 흡수는 들어온 뒤 식탁에서 얼마나 큰 접시를 받았는지를 보는 것입니다. 3편에서 다룬 「인용·언급·학습」 구분과는 또 다른 축입니다. 그쪽은 AI가 글을 어떻게 만났는지를 가르는 말이고, 이쪽은 인용된 글이 답에서 얼마나 큰 자리를 차지했는지를 가르는 말입니다.
논문 원문은 무엇을 잰다고 적었나
「+40%」가 흡수라고 판단하는 근거는 원문의 세 가지 사실입니다.
첫째, 후보가 정해져 있습니다. 논문 3.1절은 질문마다 구글 검색에서 상위 5개 출처만 가져온다고 적고 있습니다. 어떤 페이지가 후보에 들었는지는 실험이 정해 준 것이고, 엔진이 고른 것이 아닙니다.
둘째, 점수의 합이 1로 맞춰집니다. 3.4절에 따르면 한 응답 안의 모든 인용에 대한 노출 지표는 그 합이 1이 되도록 조정됩니다. 합이 정해진 점수에서는 한 페이지의 몫이 늘면 다른 페이지의 몫이 줄어듭니다.
셋째, 처치를 하지 않은 기준 점수가 19.3입니다. 다섯 후보가 똑같이 나눠 가지면 한 곳당 20%인데, 기준 점수가 그 근처에 있습니다. 이 점수가 「인용될 확률」이라면 기준이 20 근처에 놓일 이유가 없습니다.
표의 숫자는 어떻게 읽나
논문 1번 표에서 처치를 하지 않은 기준은 19.3이고, 인용문 추가가 27.2, 통계 추가가 25.2, 출처 표기가 24.6, 키워드 반복이 17.7이었습니다. 표 설명은 가장 좋은 방법이 기준보다 위치 반영 단어 수에서 41%, 주관적 인상에서 28% 나았다고 적습니다. 27.2를 19.3으로 나누면 약 1.41이니 계산도 맞습니다. 초록의 「최대 40%」는 이 계열의 숫자로 읽힙니다.
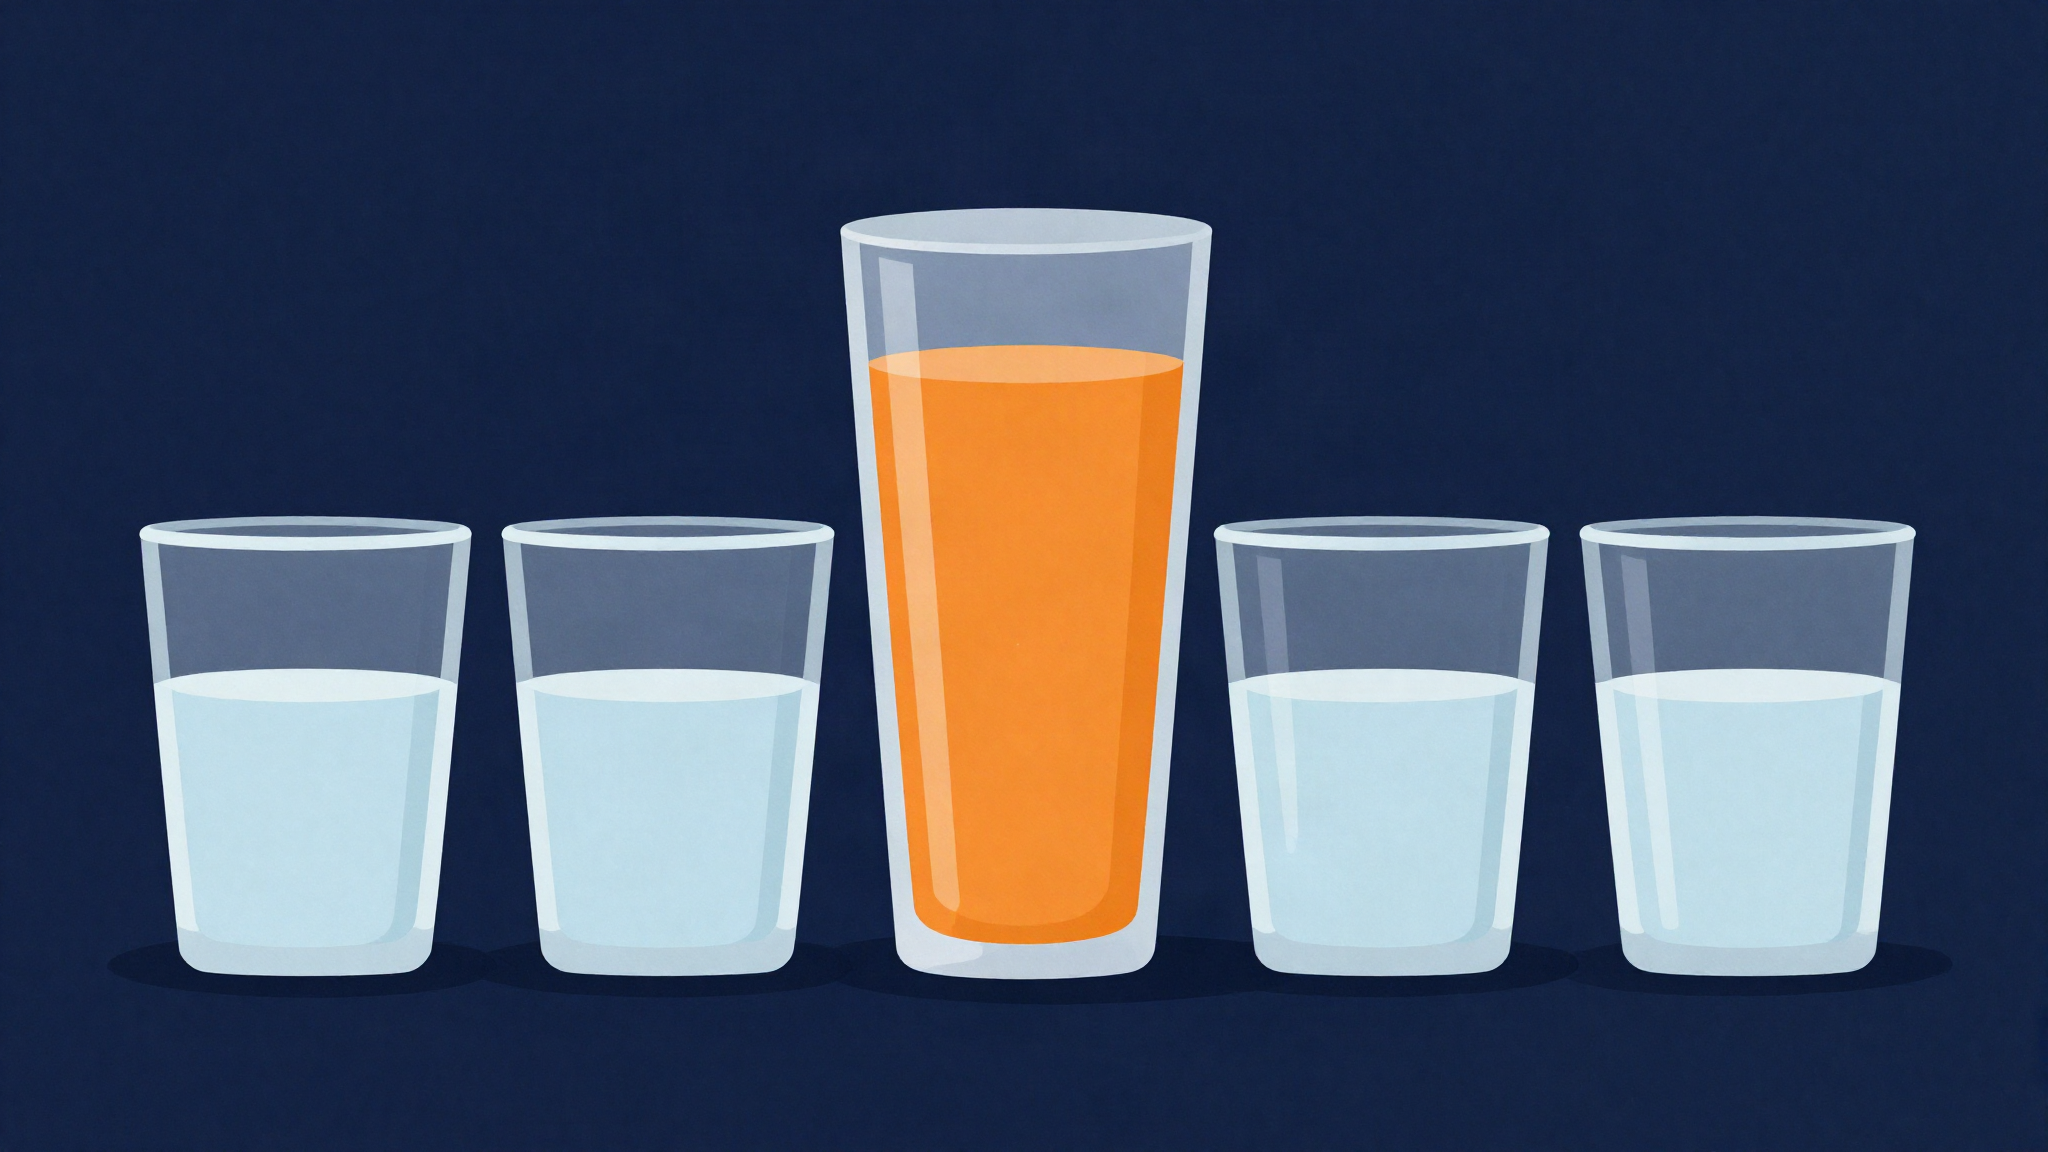
정확한 문장으로 바꾸면 이렇습니다. 「구글 상위 5개 후보 사이에서 한 페이지의 분량 몫이 19.3에서 27.2로 늘었다」입니다. 퍼센트 포인트로는 약 7.9입니다. 그런데 몫의 합이 1로 고정되어 있으니, 이 페이지가 7.9만큼 가져갔다면 나머지 네 페이지가 합쳐서 그만큼을 내놓았다는 뜻입니다. 다섯 개의 컵에 한 병의 물을 나눠 따를 때, 한 컵의 수위가 오르는 만큼 다른 컵의 수위가 내려가는 것과 같은 구조입니다.
실제 서비스에서 확인한 실험은 무엇을 말해 주나
논문은 구글 상위 5개로 꾸민 실험 외에 Perplexity.ai에서도 시험용 질문 200개로 확인했습니다. 인용문 추가는 위치 반영 단어 수를 약 22% 올렸고, 통계 추가는 주관적 인상을 최대 약 37% 올렸으며, 키워드 반복은 기준보다 약 10% 낮았습니다. 방향은 본 실험과 비슷하지만, 이것도 질문 200개 범위의 결과입니다. 그리고 여기서 올랐다는 것 역시 인용 여부가 아니라 답 안에서의 분량과 인상입니다. 서비스가 달라지면 같은 방법이 같은 크기로 통한다고 말할 근거는 이 논문 안에 없습니다.
지표 두 가지는 어떻게 다른가
위치 반영 단어 수는 출처가 답에서 차지한 단어 수를 세되, 앞쪽에 나온 문장에 더 큰 비중을 주는 방식입니다. 주관적 인상은 답 안에서 그 출처가 어떻게 보였는지를 여러 항목으로 평가해 평균한 점수입니다. 둘 다 「출처가 이미 답에 붙어 있다」는 전제 위에서 그 안의 몫을 재는 지표입니다. 그래서 두 지표가 올랐다는 말은 「붙은 뒤의 몫이 늘었다」이고, 「붙을 가능성이 늘었다」와는 다른 문장입니다.
「+40%」를 인용 확률로 읽으면 생기는 일
이 숫자를 「우리 글이 AI에 인용될 확률이 40% 오른다」로 옮기면 세 군데가 틀어집니다.
하나, 후보 안에 들어가는 문제를 건너뜁니다. 이 실험에서 다섯 페이지는 이미 후보였습니다. 현실의 AI 서비스가 어떤 페이지를 후보로 삼는지는 이 실험이 다룬 적이 없습니다.
둘, 합이 정해진 점수를 늘릴 수 있는 점수처럼 말하게 됩니다. 모든 사이트가 같은 방법을 쓰면 몫은 다시 나눠집니다.
셋, 지표의 이름이 사라집니다. 논문의 점수는 위치 반영 단어 수와 주관적 인상이지 인용 횟수가 아닙니다. 인용을 얻는 일과 인용된 뒤 큰 몫을 가져가는 일은 따로 물어야 합니다.
이 숫자를 만났을 때 물어볼 것
보고서나 영업 자료에서 「GEO로 40% 상승」이라는 문구를 만나면 네 가지를 물으면 됩니다. 무엇이 40% 올랐습니까, 인용 여부입니까 분량 몫입니까. 후보는 누가 정했습니까, 엔진입니까 실험자입니까. 점수의 합이 정해져 있습니까. 어떤 서비스와 어떤 질문 범위에서 잰 것입니까. 이 질문에 답이 없으면 그 숫자는 근거로 쓰기 어렵습니다.
이 글에서 기억할 세 가지
첫째, 「+40%」는 후보 다섯 개 사이에서 분량의 몫이 커진 흡수 숫자입니다. 둘째, 인용은 예·아니오이고 흡수는 몫이어서 서로 바꿔 읽을 수 없습니다. 셋째, 합이 1로 고정된 점수의 이득은 다른 후보의 손실과 맞물려 있습니다.
다음 편에서는 SEO, AEO, GEO, LLMO라는 이름들이 서로 어떻게 다른지 살펴봅니다.
원문과 더 많은 정리: GEO정석 https://geocanon.com
글쓴이 오세정 · 「생성형 AI는 무엇을 인용하는가」(『광고학연구』 37권 4호, 2026, DOI 10.14377/KJA.2026.8.31.7) 저자


